婴儿哭声识别:离线嵌入式哭声检测 SDK 与量产实践新增
哭声识别的价值(场景、流程)
婴幼儿的哭声既是表达需求的主要方式,也是健康状况的直接反映。核心需求是实时哭声监测与报警/反馈机制——在婴儿哭闹的第一时间通知父母,并支持及时安抚;夜间与短暂离开时的监测需求尤为迫切。
典型产品形态:婴儿监视器、智能摄像头、智能婴儿床、车载儿童遗留检测(CPD)。如今市面上的婴儿监视器在拼 2K 分辨率、云台与夜视,但几乎都是被动的——只是把视频传到父母面前,等待人来盯着看。加入设备端哭声检测后,被动摄像头变成主动报警设备,吊扇、窗帘、路过的家人都不再触发无效告警。
哭声的特点(时域与频域)
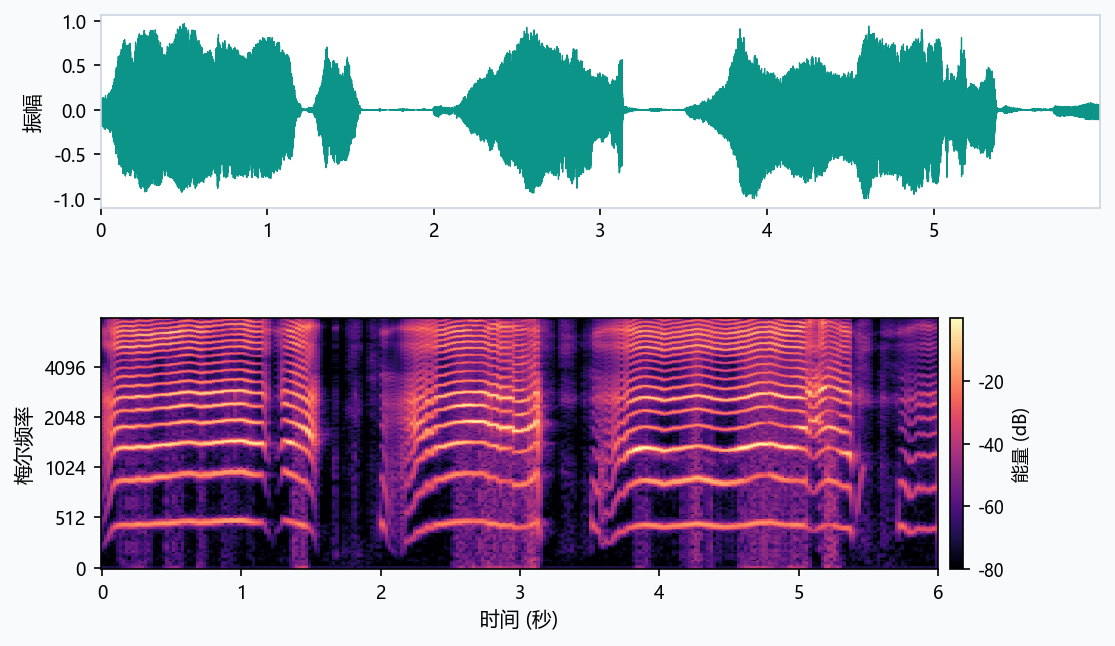
下图为一条真实哭声音频——上为波形图、下为梅尔频谱图(16kHz 采样,与模型推理使用同一套预处理参数),可以看到清晰的起—落包络与谐波结构:
试听素材(真实样本,点击播放):
🔊 真实婴儿哭声
🔊 猫叫——与哭声频谱最接近的易混淆声
从频谱上看,哭声的特征非常明显:呈现清晰的基频—共振峰结构,谐波像乐谱上的音符一样排列,基频大约在 300–500Hz,并伴随一个"起—落"的能量包络,持续相对较长的一小段时间。相比之下,说话声断续、停顿频繁;环境声(电视/谈话/家电)则没有稳定的基频结构。
因此哭声识别以频域特征为主:谐波结构是把哭声与其他声音分开的核心证据。
识别方法:预处理 → 特征提取 → 算法
信号预处理
自适应降噪 — ——实际场景存在电视声、谈话声等复杂噪声,系统实时估计并抑制背景噪声,在典型家庭噪声下信噪比提升约 **5–10dB**
端点检测与分帧 — ——先定位候选事件再进入分析
数据增强(训练阶段) — ——变速、加噪、房间冲激响应卷积,提升泛化能力
特征提取
频域 — ——FFT 变换后提取 Mel 频谱(低频滤波器密集、高频稀疏,匹配人耳听觉特性)→ 倒谱分析得到 MFCC(取 DCT 第 2–13 个系数);深度模型则直接使用 FBank 特征充分学习细节
时域 — ——短时能量、过零率、能量熵、chroma 等,并可叠加 delta / delta-delta 动态特征
识别算法
SVM 在小样本高维数据上表现稳健;随机森林抗过拟合、适合含噪数据;CNN 自动学习局部时频特征。对比实验显示,CNN + LSTM 混合模型在保持高准确率的同时具备良好实时性。此外,借助预训练模型的迁移学习加速收敛;集成学习(SVM + 随机森林 + CNN 投票/加权)进一步提升鲁棒性;用户反馈机制持续优化模型参数。
算法横向对比(2026 基准测试)
我们在 5 种真实噪声条件(安静/电视背景/白噪声/对话/街道噪声)下评估了主流方法(测试集 12,000+ 片段):
关键发现:轻量 CNN + Mel 频谱在准确率/大小比上最优;数据增强提升泛化 3–5%;INT8 量化将大小压缩 4 倍、准确率损失 <1%;电视背景音是所有方法共同的难关。
哭声识别的难点
1. 个体差异——不同婴儿的频率模式不同,同一个体在年龄、健康、情绪变化下也会改变,特征提取必须全面泛化
2. 环境噪声——电视声、谈话声、厨房声影响巨大;未做保护的识别器在嘈杂环境下误报率可高达 30% 以上,自适应降噪 + 针对性负样本训练后降至 5% 以下
3. 相似声——婴儿笑声、特别是猫叫声与哭声频谱接近,需要专项区分(我们的猫叫模型就做了双向训练)
4. 距离变化——从 0.5 米到 5 米,多距离训练数据覆盖远近场景
5. 多婴儿场景——双胞胎监视器与托育机构存在重叠哭声,测试集专门覆盖
准确率与性能
内部测试集上准确率达到 97.2%,真实家庭环境下误报率低于 2%。评估方案时可重点考察:误报率、检测距离、噪声鲁棒性、模型大小、推理延迟、平台覆盖与集成工作量。
注:文中性能指标基于内部测试环境,实际表现取决于硬件配置与使用场景。
产品形态:监视器、摄像头与车载 CPD
婴儿监视器 — ——主动报警替代被动观看;声音覆盖视频覆盖不到的黑暗、被褥与视角盲区
智能摄像头 — ——哭声识别把"宝宝需要你"从普通声音告警中区分出来
车载 CPD — ——欧盟 GSR 法规要求 2026 年 7 月起新乘用车必须配备儿童遗留检测:熄火锁车后检测儿童哭声,多级告警升级,覆盖所有座椅位置与极端高温,且误报足够低、用户不会关闭系统
运行平台与硬件要求
引擎可从 100MHz 主频级芯片起步——轻量档内存占用约 50–100KB,标准 INT8 模型在 0.2–1MB 以内。支持 Windows / Linux / macOS / Android / iOS 及各类 RTOS,架构覆盖 ARM v7/v8/v9、MIPS、x86_64——同一套 SDK,从开发板到量产产品。
从集成到持续优化
集成沿标准路径推进:在线试用 → 试用 SDK → C API 集成 → 现场验证 → 量产授权。量产之后,用户反馈闭环(误报标记 → 样本回流 → 回归测试 → OTA 更新)让准确率在产品生命周期内持续上升、误报持续下降。
完整的监测闭环:持续拾音 → 哭声事件检测 → 实时通知(推送 + 对讲入口)→ 安抚响应(白噪音/灯光/对讲)→ 用户反馈(误报标记回流样本)→ 数据沉淀与模型 OTA 升级。全部在设备端完成,音频不出设备。
C 接口与嵌入式集成
「哭声」识别库提供简洁的流式 C 接口:调用方只需持续送入 16kHz 单声道 PCM,拼帧、Mel 预处理与模型推理全部在内部完成,帧级概率经报警策略聚合成「哭声事件」回调输出。
完整接口声明(cry_detect.h):
/**
 * cry_detect.h — 哭声识别统一接口
 *
 * 封装 Mel 预处理 + 推理引擎 + 报警策略, 内部模型消费线程处理音频。
 * 与录音模块 (audio_capture.h) 相互独立: 调用者自行决定音频来源
 * (录音回调 / wav 文件 / 网络流), 通过 cry_detect_feed 送入, 数据任意大小。
 *
 * 用法 (实时录音模式):
 *   cry_detect_t *d = cry_detect_create(mgk_path, NULL, NULL);
 *   cry_detect_set_listener(d, on_frame, on_onset, on_offset, NULL);
 *   cry_detect_start(d);                       // 启动内部模型消费线程
 *   audio_capture_start(rec, capture_cb, d);   // 录音回调里调 cry_detect_feed
 *   ...
 *   cry_detect_stop(d);                        // 排空缓冲, 停止线程
 *   cry_detect_destroy(d);
 *
 * 用法 (wav 文件模式):
 *   cry_detect_t *d = cry_detect_create(mgk_path, NULL, NULL);
 *   cry_detect_set_listener(d, on_frame, on_onset, on_offset, NULL);
 *   cry_detect_start(d);
 *   循环读文件: cry_detect_feed(d, pcm, n);    // 任意数据大小
 *   cry_detect_stop(d);
 *   cry_detect_destroy(d);
 */

#ifndef CRY_DETECT_H
#define CRY_DETECT_H

#include <stdint.h>

#ifdef __cplusplus
extern "C" {
#endif

/* 识别事件 (报警策略输出, 用于事件结束回调) */
typedef struct {
    float start_time;       /* 事件开始时间 (秒) */
    float end_time;         /* 事件结束时间 (秒) */
    float confidence;       /* 事件置信度 */
    float max_confidence;   /* 事件内最大帧置信度 */
    int   frame_count;      /* 事件持续帧数 */
} cry_detect_event_t;

/* 帧级回调: 每帧识别结果 (模型线程内执行) */
typedef void (*cry_detect_frame_cb_t)(float cry_prob, float timestamp,
                                      void *user_data);

/* 事件开始回调: 策略判定哭声开始, 只有开始时间 */
typedef void (*cry_detect_onset_cb_t)(float start_time, void *user_data);

/* 事件结束回调: 策略判定哭声结束 (或停止识别时未结束的事件), 完整事件信息 */
typedef void (*cry_detect_offset_cb_t)(const cry_detect_event_t *event,
                                       void *user_data);

typedef struct cry_detect_s cry_detect_t;

/* 创建/销毁; alarm_name/alarm_params 可传 NULL (用默认策略及参数) */
cry_detect_t *cry_detect_create(const char *mgk_path,      /* 模型文件路径 (必填) */
                                const char *alarm_name,    /* 报警策略名, NULL=默认 */
                                const char *alarm_params); /* 策略参数 key=val,key=val, NULL=默认 */
void cry_detect_destroy(cry_detect_t *det);

/* 设置事件回调 (create 后调用, 也可在运行中调整); 不需要的回调传 NULL */
void cry_detect_set_listener(cry_detect_t *det,
                             cry_detect_frame_cb_t  on_frame,
                             cry_detect_onset_cb_t  on_onset,
                             cry_detect_offset_cb_t on_offset,
                             void *user_data);

/* 启动/停止识别: 启动内部模型消费线程 / 排空缓冲后停止线程 */
int  cry_detect_start(cry_detect_t *det);
void cry_detect_stop(cry_detect_t *det);
int  cry_detect_is_running(cry_detect_t *det);

/* 设置事件识别策略 (可在运行中调整) */
int cry_detect_set_alarm(cry_detect_t *det, const char *alarm_name,
                         const char *alarm_params);

/* 送入 PCM 数据 (16bit 单声道 16kHz), 线程安全, 任意数据大小 */
int cry_detect_feed(cry_detect_t *det, const int16_t *pcm, int num_samples);

#ifdef __cplusplus
}
#endif

#endif /* CRY_DETECT_H */
最简 wav 推理示例(节选,完整文件位于 SDK 的 src/cryDetect/v7_src/c/main.c):
#include <stdio.h>
#include <stdlib.h>
#include <stdint.h>
#include "cry_detect.h"

#define DEFAULT_MGK  "cry_detect_v7.mgk"  /* 模型文件 */
#define DEFAULT_WAV  "test_cry.wav"       /* 16kHz 单声道 16bit PCM */
#define FEED_CHUNK   16000                  /* 每次送入 1 秒音频 */

/* 帧级回调: 每帧输出哭声概率 (约 1 秒一帧) */
static void on_frame(float cry_prob, float timestamp, void *user_data)
{
    (void)user_data;
    printf("%8.2fs  cry=%.4f\n", timestamp, cry_prob);
}

/* 事件开始回调: 策略判定哭声事件开始 */
static void on_onset(float start_time, void *user_data)
{
    (void)user_data;
    printf("[EVENT] cry start at %.2fs\n", start_time);
}

/* 事件结束回调: 应用层可据此做后续统计或分级响应 */
static void on_offset(const cry_detect_event_t *ev, void *user_data)
{
    (void)user_data;
    printf("[EVENT] cry end at %.2fs (dur=%.2fs, conf=%.3f, frames=%d)\n",
           ev->end_time, ev->end_time - ev->start_time,
           ev->confidence, ev->frame_count);
}

static int read_wav_pcm(const char *path, int16_t **pcm, int *n, int *sr);  /* 完整实现见源文件 */

int main(void)
{
    cry_detect_t *det;
    int16_t *pcm = NULL;
    int num_samples = 0, sample_rate = 0;
    int pos;

    if (read_wav_pcm(DEFAULT_WAV, &pcm, &num_samples, &sample_rate) != 0)
        return 1;

    /* 1. 创建识别器: 模型文件 + 默认报警策略 (NULL) */
    det = cry_detect_create(DEFAULT_MGK, NULL, NULL);
    if (!det) return 1;

    /* 2. 注册回调 (均为可选) */
    cry_detect_set_listener(det, on_frame, on_onset, on_offset, NULL);

    /* 3. 启动内部模型消费线程 */
    cry_detect_start(det);

    /* 4. 分块送入 PCM; 实时录音时改在录音回调里 feed */
    for (pos = 0; pos < num_samples; pos += FEED_CHUNK) {
        int n = num_samples - pos;
        if (n > FEED_CHUNK) n = FEED_CHUNK;
        cry_detect_feed(det, pcm + pos, n);
    }

    /* 5. 停止并销毁 */
    cry_detect_stop(det);
    cry_detect_destroy(det);
    free(pcm);
    return 0;
}
编译与运行(示例):
$(CC) main.c -I. -L. -lcrydetect -lpthread -lm -o cry_detect_v7
./cry_detect_v7
结语
哭声识别让婴儿产品从"摄像头"变成"照看者"。如果你正在打造婴儿监视器、摄像头或车载 CPD 系统,我们提供在线试用与完整的技术支持。